#seo#ia#agentes15 min de leitura
AEO vs SEO: será que o SEO morreu?
SEO é pra quem clica no resultado da busca; AEO é pra quem responde no lugar do leitor. Como eu preparei o meu site pras duas coisas, o que 15 dias de dados mostraram sobre quem lê o quê e onde a pesquisa da indústria discorda de mim.
Ajustes de leitura
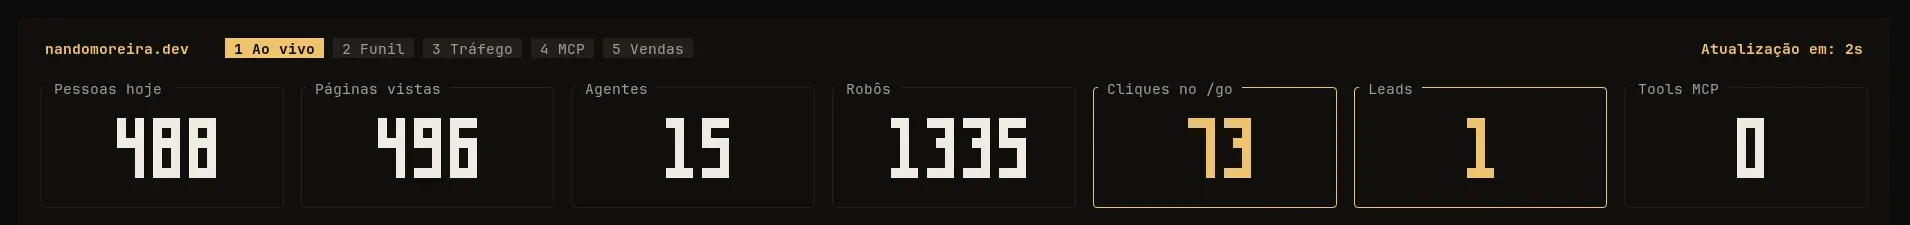
Hoje o painel do meu site mostrou 488 pessoas, 15 agentes de IA e 1.335 robôs. E zero chamadas de tool no servidor MCP que eu deixei lá justamente pros agentes.
Dá pra perguntar se o SEO morreu, agora que muita gente pergunta pro ChatGPT em vez de procurar no Google. Antes de responder, vale olhar quem lê o seu site de verdade. O meu é lido por gente, por buscador e por agente, e cada um quer um formato diferente. Os números de 15 dias mostram uma coisa que eu não esperava: pra um agente de IA, o HTML é o formato que ele menos lê no meu site.
SEO é pra quem clica, AEO é pra quem responde
SEO (otimização pra mecanismos de busca) é fazer a sua página aparecer bem posicionada quando alguém busca, pra que essa pessoa clique e chegue até você. AEO (otimização pra motores de resposta) é fazer um assistente como o ChatGPT, o Perplexity ou o Claude ler o seu conteúdo, entender e usar na resposta que ele dá, muitas vezes sem a pessoa nunca abrir o seu site. Você vai ver o mesmo terreno com outros nomes, como GEO (generative engine optimization, termo de um artigo acadêmico de 2023) e LLMO. Eu uso AEO no texto inteiro pra não misturar.
| SEO | AEO | |
|---|---|---|
| Quem lê primeiro | o crawler do buscador | o crawler ou o agente de um assistente |
| O que ele quer | saber do que a página trata e se ela merece posição | o conteúdo limpo, pra citar ou responder |
| Quem chega no fim | uma pessoa, pelo clique | às vezes ninguém: a resposta basta |
| Como se mede | posição e cliques vindos da busca | leituras das rotas de máquina e citações |
O meu motivo pra fazer a segunda coluna foi uma aposta. Quando reescrevi o site em 2026, o meu trabalho do último ano era construir ferramenta de agente de IA, e eu quis que o site fosse legível por um agente. A IA já entra na triagem de candidato: segundo uma reportagem da Corp! Magazine de junho de 2026, 44% dos profissionais de RH ouvidos pela SHRM usam IA pra revisar currículos, e 42% dos recrutadores da pesquisa da Bullhorn pra triar candidatos. Isso é a triagem do currículo. Já um agente visitando o site do candidato antes de um humano ler qualquer coisa eu não achei medido em lugar nenhum, então esse motivo continua sendo hipótese minha, e os números abaixo são o que eu tenho pra testá-la.
O que encolheu foi o clique
A queda do clique tem número, e ele vem de mais de um lugar. O Pew acompanhou a navegação real de 900 adultos nos EUA em março de 2025: quando a busca mostrava um resumo de IA, 8% das visitas terminaram em clique num resultado tradicional, contra 15% sem o resumo. Só 1% clicou num link dentro do resumo. E 26% encerraram a sessão ali, contra 16% (Pew, julho de 2025). A Ahrefs olhou 300 mil palavras-chave e, em fevereiro de 2026, estimou que a presença de AI Overview vem junto com um CTR 58% menor na primeira posição, contra 34,5% no estudo de abril de 2025 (Ahrefs). E a SparkToro, com dados da Similarweb, contou 68,01% das buscas no Google terminando sem clique nos EUA no começo de 2026, com o aviso do próprio autor de que o número de 2024 (60,45%) veio de outro painel (SparkToro, junho de 2026).
Nem todo estudo concorda. A Semrush acompanhou as mesmas palavras-chave antes e depois de ganharem AI Overview e viu o zero-clique cair de 33,75% pra 31,53%, o que quer dizer que as pessoas clicaram um pouco mais (Semrush, dezembro de 2025). A explicação deles é que essas buscas já eram informacionais e que o AI Overview se espalhou pra outros tipos de busca. Eu fico com a versão cautelosa. Pra quem depende do clique informacional no topo, o efeito médio é negativo, e o tamanho varia com o tipo de busca e com o mês. Todos esses estudos são dos EUA. Eu não achei o equivalente pra busca brasileira.
O que dá pra dizer do Brasil é o volume. Entre janeiro e agosto de 2025, o Google somou 38,57 bilhões de visitas no país e o ChatGPT, 1,97 bilhão, segundo a Cadastra e a Similarweb (Exame, novembro de 2025). O ChatGPT cresceu 71,9% no período, e a busca continua umas vinte vezes maior. No mundo, a Similarweb contou em junho de 2025 1,13 bilhão de visitas vindas de plataformas de IA aos mil maiores sites, contra 191 bilhões vindas do Google (Similarweb, julho de 2025). O clique encolheu. A busca segue sendo o grosso do tráfego.
Do lado de quem publica, a Cloudflare mediu a conta que isso deixa. Em julho de 2025 o crawler da Anthropic puxou 38.000 páginas pra cada visitante que a empresa mandou de volta, e o da Perplexity, 194 (Cloudflare, agosto de 2025). A maior parte desse crawl é de treino, que não tem a função de mandar visita. Mesmo assim, é a coluna “às vezes ninguém” da tabela que esses números descrevem.
O SEO continua lá, e é a base das duas coisas
Antes de qualquer coisa pra IA, o site tem o SEO de sempre: sitemap.xml, URL canônica absoluta em toda página, imagem de compartilhamento gerada por página, RSS e um seoTitle quando o título do post é longo demais pro resultado da busca.
Quem decide isso do lado do Google diz o mesmo. No guia de otimização pra recursos de IA generativa, publicado em maio de 2026 e atualizado em julho, a resposta pra “o SEO ainda importa pra busca com IA?” é “sim”. Os recursos de IA se apoiam nos mesmos sistemas de ranking e de qualidade da busca. Sobre AEO e GEO, o texto diz que, do ponto de vista do Google Search, otimizar pra busca com IA é otimizar a experiência de busca, e portanto continua sendo SEO. O Danny Sullivan já tinha dito algo parecido em dezembro de 2025: SEO pra IA ainda é SEO.
Os dados estruturados entram aqui, e é onde eu mais mudei de ideia ao pesquisar. Uso um bloco de JSON-LD (o formato do schema.org que descreve a página em campos, não em texto) no <head>. O site declara quem eu sou (Person), o que é o site (WebSite), o que é cada página (WebPage) e cada projeto do portfólio (SoftwareApplication quando tem link no ar, CreativeWork quando não tem). Eu achava que isso ajudava o agente a não ter que adivinhar quem escreveu o quê. O Google diz o contrário no mesmo guia: dado estruturado não é requisito pras respostas de IA, e não existe nenhum markup especial do schema.org que você precise adicionar pra isso. Continua valendo como parte do SEO, porque habilita os resultados enriquecidos da busca. Então o JSON-LD do meu site está lá pelo SEO de sempre, e eu não o trato como atalho pra aparecer numa resposta de IA. Essa posição é do Google sobre as funções do Google. Pro ChatGPT, o Perplexity e o Claude, eu não encontrei estudo que meça o efeito.
Um detalhe que custa uma linha e evita dor: todo JSON-LD sai por uma função só, que escapa o <. Sem isso, um título com </script> fecha a tag no meio do conteúdo, e um teste reprova quem tentar reimplementar o escape em outro lugar.
Libere os crawlers de IA pelo nome
O robots.txt com User-agent: * e Allow: / já deixa todo mundo entrar. Mesmo assim, o meu lista um por um os crawlers de IA:
export const ANSWER_ENGINE_CRAWLERS = [
  'GPTBot',
  'OAI-SearchBot',
  'ChatGPT-User',
  'ClaudeBot',
  'Claude-User',
  'Claude-SearchBot',
  'PerplexityBot',
  'Perplexity-User',
  'Google-Extended',
  'Applebot-Extended',
  'CCBot',
] as const;
O comentário no código explica o porquê: a lista documenta a intenção, e sobrevive ao dia em que eu apertar a regra padrão. Se um dia o * virar Disallow, os onze continuam entrando, e ninguém precisa lembrar que eles existiam.
Listar pelo nome também obriga a saber o que cada um faz, porque treino, busca e pedido do usuário são bots diferentes. A documentação da OpenAI separa o GPTBot, que coleta conteúdo que pode virar treino, o OAI-SearchBot, que decide se o site aparece na busca do ChatGPT, e o ChatGPT-User, que visita uma página quando alguém pede. Sobre esse último, a própria documentação avisa: como a ação é iniciada pelo usuário, as regras do robots.txt podem não se aplicar. A página da Anthropic tem a mesma divisão: o ClaudeBot coleta pra treino, o Claude-User busca páginas a pedido de quem conversa com o Claude, e o Claude-SearchBot indexa conteúdo pra melhorar a busca. Bloquear só o de treino e deixar o resto liberado é uma escolha que o robots.txt permite. O meu libera todos. É decisão de site pessoal, não recomendação pra todo mundo.
Só não confunda isso com segurança. O robots.txt é um pedido educado, e crawler mal-educado ignora. Em agosto de 2025 a Cloudflare mostrou que a Perplexity, quando bloqueada, trocava o user agent declarado por um Chrome genérico, e que no mesmo teste o ChatGPT-User parou ao encontrar um Disallow (Cloudflare). A Perplexity contestou a atribuição. A proteção de verdade é não ter nada sensível nas rotas públicas, e o site tem um teste que varre as rotas de máquina atrás de e-mail, chave, caminho absoluto e IP privado.
Dê uma versão em Markdown pra cada página
Essa foi a técnica que mais deu leitura de agente no meu site, e eu tenho o número.
Toda página do site tem uma irmã em Markdown: /tratando-dotfiles-como-software tem /tratando-dotfiles-como-software.md, com o texto limpo, um cabeçalho com título, URL e data, e nada de menu, rodapé ou script. Tem também uma versão /ia, a mesma coisa renderizada pra uma pessoa ver como o agente enxerga a página. As duas saem de uma tabela só (caminho pra Markdown), e página fora dela responde 404. O HTML anuncia a irmã no <head>:
<link rel="alternate" type="text/markdown" href="/tratando-dotfiles-como-software.md" />O analytics do site classifica cada visita por user agent em gente, agente de IA, buscador e outros robôs, e mede no servidor, sem script no navegador. De 14 a 28 de outubro, as leituras de conteúdo feitas por agentes de IA ficaram assim:
| Formato | Leituras de agentes |
|---|---|
.md |
429 |
/ia |
376 |
| HTML | 245 |
Três em cada quatro leituras foram nas duas versões feitas pra máquina, e a mais lida de todas é o Markdown puro. No meu site, quando o texto limpo existe, o agente lê o texto limpo, e ele acha a versão sozinho pelo link do <head>.
Esse número tem limites, e o primeiro é que ele mede leitura, não citação. Eu não sei quantas dessas 1.050 leituras viraram resposta pra alguém. O Dries Buytaert, que fez o mesmo experimento no blog dele, anunciou o .md com o mesmo rel="alternate" e olhou um mês de logs da Cloudflare. Os crawlers acharam o Markdown pelo link, e nenhum usou o cabeçalho Accept: text/markdown. A fatia de pedidos em .md variou muito: 34,8% no GPTBot, 22,7% no OAI-SearchBot, 2,1% no ClaudeBot e 0,1% no ChatGPT-User. O tráfego de crawler dele subiu uns 7%, porque os bots pedem o HTML e o Markdown. Ele não conseguiu demonstrar ganho de citação. A conclusão dele: se dá trabalho, gaste o esforço no conteúdo.
Não dá pra dizer que a gente mede públicos diferentes. A categoria “agente de IA” do meu analytics também mistura crawler de treino (GPTBot, ClaudeBot, CCBot), de busca e de usuário, como os logs dele. Mesmo assim, no meu site três em cada quatro leituras foram nas versões pra máquina, e no dele o HTML ficou com a maior parte dos pedidos. Com o que eu tenho, não sei explicar essa diferença.
Tem também quem seja contra a ideia. Em fevereiro de 2026, o John Mueller, do Google, chamou de “stupid idea” converter as páginas em Markdown pros bots. O alvo dele era um middleware que detecta o GPTBot ou o ClaudeBot e troca a resposta do HTML por um arquivo de texto, sem menu, sem links internos. O guia do Google de 2026 também diz que você não precisa de arquivos de IA nem de Markdown pra aparecer no Google Search, porque ele não os usa. E a Profound rodou um experimento controlado, em 381 páginas de 6 sites, servindo Markdown a metade delas pros bots: mediu cerca de uma visita extra na mediana, sem significância estatística (Profound, fevereiro de 2026).
Nada disso descreve o meu site. Eu entrego HTML pro humano, anuncio a irmã com rel="alternate" e não troco a resposta por user agent. A Profound mediu volume de visita de bot, e o meu painel mede qual URL o agente escolhe quando as duas existem. São perguntas diferentes. O que eu afirmo é a segunda, no meu site, em 15 dias. Que o Markdown aumente a citação, eu não afirmo.
O llms.txt que quase ninguém leu
Todo guia de AEO manda criar o llms.txt, um índice em Markdown na raiz do site, com um resumo de quem você é e links anotados pras páginas que importam (a proposta do Jeremy Howard está aqui). O meu existe desde o lançamento, junto com um llms-full.txt com tudo num arquivo só, e os dois são gerados a partir da mesma camada de dados das páginas. Um llms.txt escrito à mão fica desatualizado na primeira mudança no portfólio.
No mesmo período, o llms.txt teve 6 leituras de agentes de IA. E 65 de visitas classificadas como gente (eu suspeito de dev curioso, mas o analytics não guarda o user agent, então não dá pra saber).
O resto da internet viu parecido. A Ahrefs olhou 137 mil domínios em maio de 2026: 28% publicam um llms.txt, e 97% desses arquivos não receberam nenhum pedido no mês (Ahrefs, junho de 2026). Dos pedidos que existiram, 96% eram de bots, e só 19,5% de ferramentas de IA nomeadas. Os bots de IA também não saem procurando o arquivo onde ele não existe. No blog do Dries foram 52 pedidos em um mês, todos de ferramentas de auditoria de SEO, e ele resumiu o llms.txt como uma solução procurando um problema. O Google diz que ignora o arquivo e que mantê-lo não ajuda nem atrapalha.
O AGENTS.md é a mesma ideia com outro público: um brief de contratação, com serviços, disponibilidade e como chamar os endpoints. Teve 10 leituras de agentes e 116 de gente. Os dois continuam lá, porque custam nada pra manter. Mas se eu tivesse que escolher uma coisa só pra fazer hoje, faria a versão em Markdown de cada página antes do llms.txt.
O MCP que ninguém chama
O site também tem um servidor MCP (o Model Context Protocol, um jeito padrão de um assistente chamar funções de um serviço) em /api/mcp, com cinco tools: listar projetos, detalhar um projeto, perfil, currículo e disponibilidade. E um /api/hire, pra um agente mandar uma proposta em nome de alguém. Contei como montei isso no post do MCP.
No dia 17, o painel mostrava acesso de agente no “Ao vivo” e zero em “Chamadas de tool”. Achei que era bug na contagem. Não era. O evento bruto mostrou só a sequência de conexão: server/discover, initialize, notifications/initialized, tools/list. É o aperto de mão que o Claude Code faz quando abre uma sessão com o MCP configurado. A tool só é chamada se o modelo decidir usar uma, e ninguém tinha decidido. Pra provar, chamei get_profile em produção e o contador subiu de nada pra 1.
Nos 15 dias, foram 149 conexões e 2 chamadas de tool. Uma delas foi esse meu teste. E pra piorar (pra mim), parte das conexões é minha: o cookie que marca as minhas visitas não vai junto numa chamada MCP, e as 19 conexões do cliente claude-code são as minhas próprias sessões.
O protocolo cresce, só que em outro lugar. No primeiro aniversário, em 25/11/2025, o registro oficial tinha perto de 2.000 servidores, 407% a mais que em setembro (blog do MCP). Isso fala de servidores e clientes, e o meu painel fala de um portfólio que um agente visita de passagem. Eu não achei nenhum levantamento da taxa de chamada de tool em sites públicos, então os 149 e os 2 são uma anedota bem medida, e não uma estatística.
O MCP funciona. Só que hoje um agente que chega no site lê o Markdown e vai embora, em vez de conectar e perguntar.
Eu continuo fazendo os dois
Os números do meu site puxam pros dois lados. Em 15 dias, a busca trouxe pouca gente: 17 visitas do Google, 2 do Bing e 2 do DuckDuckGo, contra 168 do LinkedIn. Isso é um site pessoal pequeno, e não diz nada sobre a indústria. E os agentes leram o site mais de mil vezes, sem que eu saiba quantas dessas leituras viraram resposta pra alguém.
Mas tudo o que eu fiz pros agentes está em cima do que o SEO já pedia: o sitemap.xml com todas as páginas, a URL canônica que diz qual versão vale e o JSON-LD que diz quem escreveu, que serve ao SEO e que eu não vendo como atalho de IA. O Dries chegou na mesma conclusão pelo caminho dele: o que continua funcionando é escrita clara, conteúdo com autoridade e publicação em dia. O guia do Google põe no topo da lista o conteúdo único e útil, e diz que ele pesa mais, a longo prazo, que qualquer outra sugestão do texto.
Minha resposta pro título é que o SEO não morreu. Quem publica agora tem dois públicos, o que clica e o que responde no lugar de quem clicaria, e a parte que encolheu foi o clique informacional. Eu continuo fazendo os dois, no mesmo código. Cada página nova nasce com o HTML pro humano, a versão em Markdown pro agente e os dados estruturados pra busca.
User-agent: *
DISCUSSÃO
Deixe seu comentário e vamos discutir sobre esse artigo
Oops, erro ao carregar os comentários, volte aqui mais tarde.
Nenhum comentário ainda. Seja o primeiro a escrever.
